Практическая проверка чтения PDF
PDF открывается, но ИИ читает его неправильно: текстовые и сканированные файлы
PDF может открываться и выглядеть вполне читаемым, но не отдавать ни строки инструменту извлечения текста. Если в ответе ИИ странные числа или пересказ, сначала стоит понять, какой материал получил инструмент. Мы сделали две версии небольшой армянской карточки и проверили извлечение, не загружая файлы в ChatGPT.
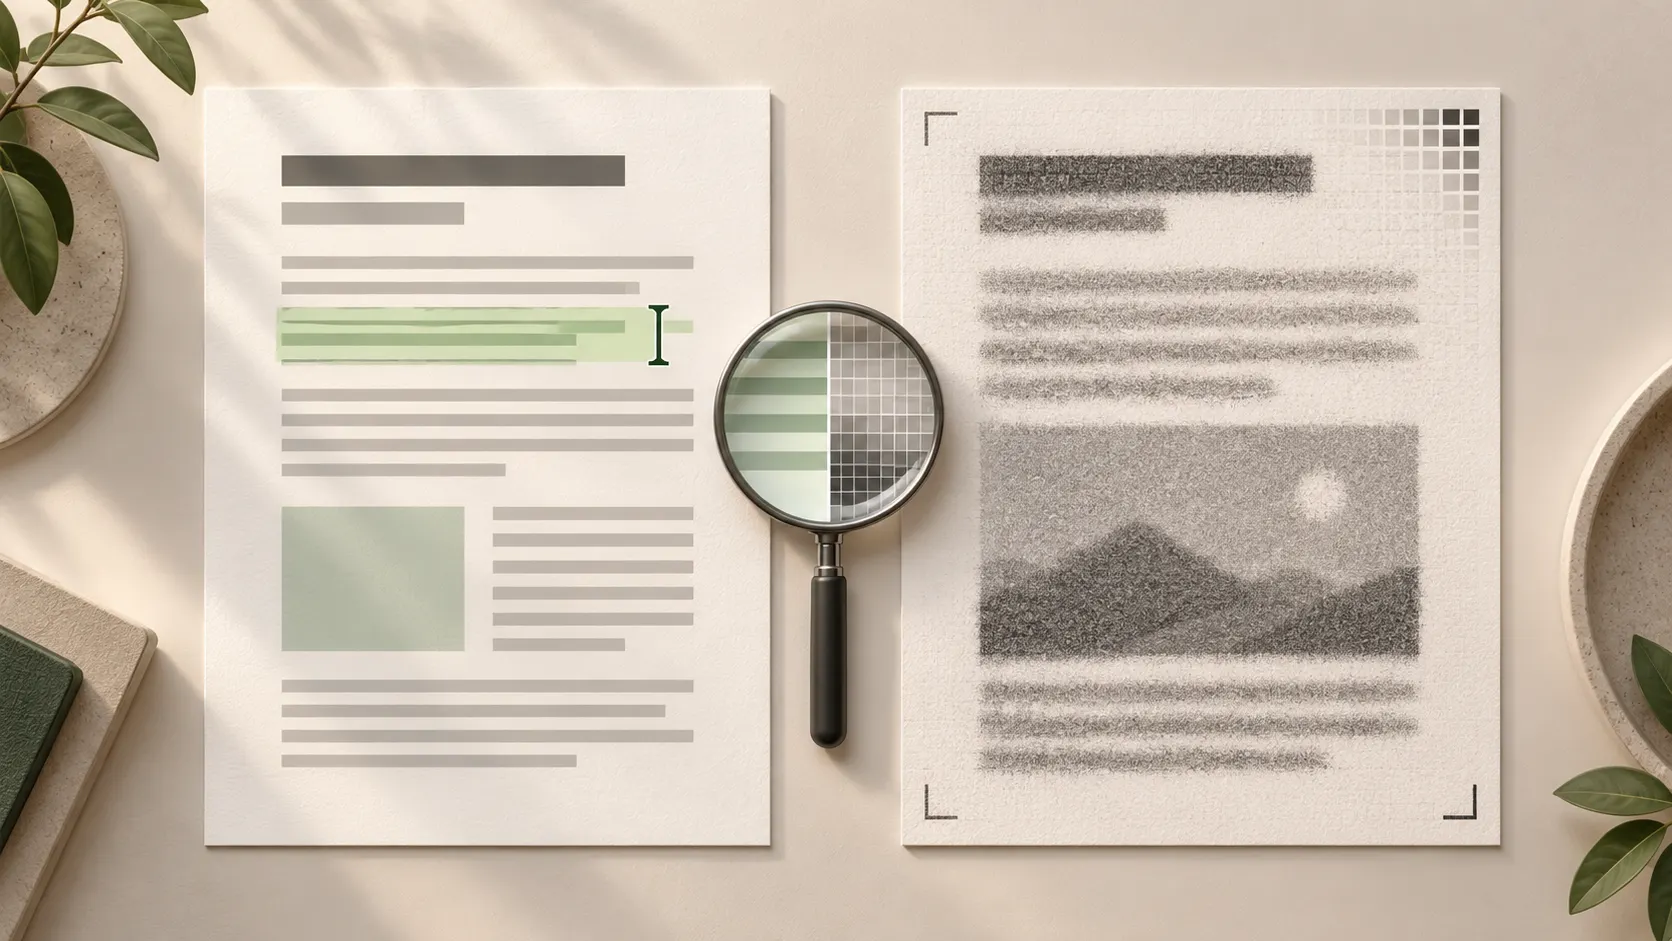
Читаемое изображение страницы ещё не означает, что в PDF есть извлекаемый текст. Сравните небольшой фрагмент на странице с полученным текстом. Для страницы-картинки может понадобиться OCR или инструмент с обработкой изображений; имена, числа и связи полей всё равно нужно сверять с оригиналом. Наш опыт измеряет извлечение текста, а не точность ИИ.
Одинаковая страница может быть устроена по-разному
В текстовом PDF буквы сохранены как текстовые элементы. В версии только с изображением страница представляет собой картинку: человек видит буквы, но обычный извлекатель не превращает их в слова автоматически. Реальные файлы также бывают смешанными или содержат текстовый слой, добавленный OCR.
Официальное руководство pypdf указывает, что со страницы-картинки может извлекаться мало текста или ничего. Поэтому расширение .pdf само по себе не описывает доступные внутри данные. Увеличение картинки может улучшить её видимость, но само по себе не добавляет текстовый слой.
Какой материал мы сравнили
1 ноября 2026 года мы составили одностраничную полностью вымышленную карточку заказа на армянском. Это не документ клиента, цены не являются рыночным предложением, а дата не обещает доставку. Шесть полей в переводе выглядят так.
Первый PDF создан с текстовыми элементами. Затем его страницу превратили в изображение и вставили эту же картинку во второй PDF без OCR и дополнительного текста. Это чистая имитация структуры скана, а не испытание физического сканера, размытой фотографии или рукописи.
- Товар: синяя тетрадь.
- Количество: 12 штук.
- Цена единицы: 1 250 драмов.
- Доставка: 1 500 драмов.
- Итого: 16 500 драмов.
- Условная дата передачи: 2026-11-05.
Наблюдение: одинаковый вид, разное извлечение
Оба PDF содержат одну страницу. Их изображения после рендеринга с разрешением 150 dpi совпали попиксельно. Армянский текст и числа читаемы, строки не обрезаны. Затем из тех же файлов извлекли текст с помощью pypdf 6.10.0 и pdfplumber.
Из текстового PDF оба инструмента вернули все восемь исходных строк: заголовок, пометку об учебном примере и шесть полей. Числа и дата сохранились. Из PDF-картинки оба вернули ноль непробельных символов. В этой версии обнаружен один объект изображения.
Наблюдения относятся только к двум нашим файлам и указанным извлекателям. Загрузка в ChatGPT, API-запрос, OCR и ручное выделение текста в PDF-просмотрщике не выполнялись. Поэтому нельзя заключать, что ИИ не прочитал бы эту страницу или что все сканы нечитаемы.
OCR и чтение изображений отличаются от извлечения текста
OCR пытается получить текст из букв на изображении. Официальное руководство Adobe описывает добавление поискового текста в сканированный PDF и проверку результата распознавания. Мы этот шаг не выполняли и не приводим оценку качества языка или процент ошибок OCR.
Пустое извлечение также не доказывает, что инструмент ИИ с обработкой изображений не прочитает PDF. Текущая документация API OpenAI описывает использование и извлечённого текста, и изображений страниц для моделей с возможностями зрения. Это описание механизма API, а не результат нашего опыта или подтверждение всех функций вашего аккаунта ChatGPT.
Карточка решения перед обработкой всего документа
Выберите короткий неконфиденциальный фрагмент: заголовок, имя, число и дату. По возможности скопируйте или извлеките его и сопоставьте результат с изображением страницы. Успешное выделение текста — лишь предварительный признак: проверьте, что именно получилось.
Прежде чем просить красивое резюме всего документа, выясните, корректно ли прочитан исходный материал. Если проблема только в отдельных страницах, сохраняйте их исходные номера при проверке небольшого фрагмента.
- Текст есть и совпадает с оригиналом: продолжайте небольшими частями, проверяя имена и числа.
- Текст не получен: уточните поддержку OCR или изображений; по возможности возьмите исходный текстовый материал.
- Текст есть, но символы неверны: проверьте распознавание, шрифт или более качественную версию источника.
- Числа верны, но строки смешаны: восстановите связи полей и значений и сверьтесь с оригиналом.
- Содержание остаётся неподтверждённым: отметьте открытый вопрос, не заполняйте пробел догадкой.
Сохраняйте оригинал и пределы проверки
Начните с собственного вымышленного примера. Перед отправкой реального документа в сервис убедитесь, что вправе это делать, и уберите идентифицирующие или конфиденциальные детали, не нужные для задачи. Закрыть одно имя может быть недостаточно, если другие сведения позволяют узнать человека или организацию.
Сохраните версию файла, проверенную страницу, название инструмента, извлечённый текст и неустановленные поля. Наш вывод ограничен: одинаково выглядящие PDF могут давать извлекателю разные текстовые данные. Проверка источников ответа ИИ — отдельная задача, как и освоение ИИ для повседневной работы на армянском.
Что запомнить
- Внешний вид страницы и извлекаемый текст проверяются отдельно.
- Оба извлекателя получили восемь строк из текстового PDF и ноль непробельных символов из версии-картинки.
- Это не тест точности ChatGPT, OCR или всех PDF.
- До пересказа проверьте имена, числа и связи полей по оригиналу.
Частые вопросы
ИИ всегда неверно читает сканированные PDF?
Нет. Результат зависит от файла и механизма инструмента. Наш опыт показывает только различие между извлечением текста и чтением изображения страницы.
Если текст копируется, проверка больше не нужна?
Нужна. В скопированном тексте могут быть ошибочные символы, числа или порядок чтения. Сравните небольшой фрагмент с изображением страницы.
В вашем примере ChatGPT не распознал армянский?
Такой опыт не выполнялся. Мы записали результаты извлечения pypdf и pdfplumber из двух PDF-версий одной вымышленной армянской карточки.
Какой файл выбрать, если есть исходный документ?
Начните с подходящей для задачи версии, которую можете проверить. Исходный текстовый материал может помочь, но связи в таблицах и сохранность структуры всё равно нужно проверить.
Источники
Проверено: