PDF-ի ընթերցման գործնական ստուգում
PDF-ը բացվել է, բայց ԱԲ-ն սխալ է կարդում․ տեքստային և սկանավորված ֆայլերի տարբերությունը
PDF-ը կարող է պարզ բացվել և ընթեռնելի երևալ էկրանին, բայց տեքստ արտահանող գործիքին ոչ մի տող չտալ։ Եթե ԱԲ-ից ստացած ամփոփումը կամ թվերը տարօրինակ են, նախ արժե հասկանալ՝ ինչ տեսակի նյութ է գործիքը ստացել։ Մենք նույն փոքր հայերեն քարտը պատրաստեցինք երկու ձևով և ստուգեցինք արտահանումը՝ առանց ֆայլերը ChatGPT-ին ուղարկելու։
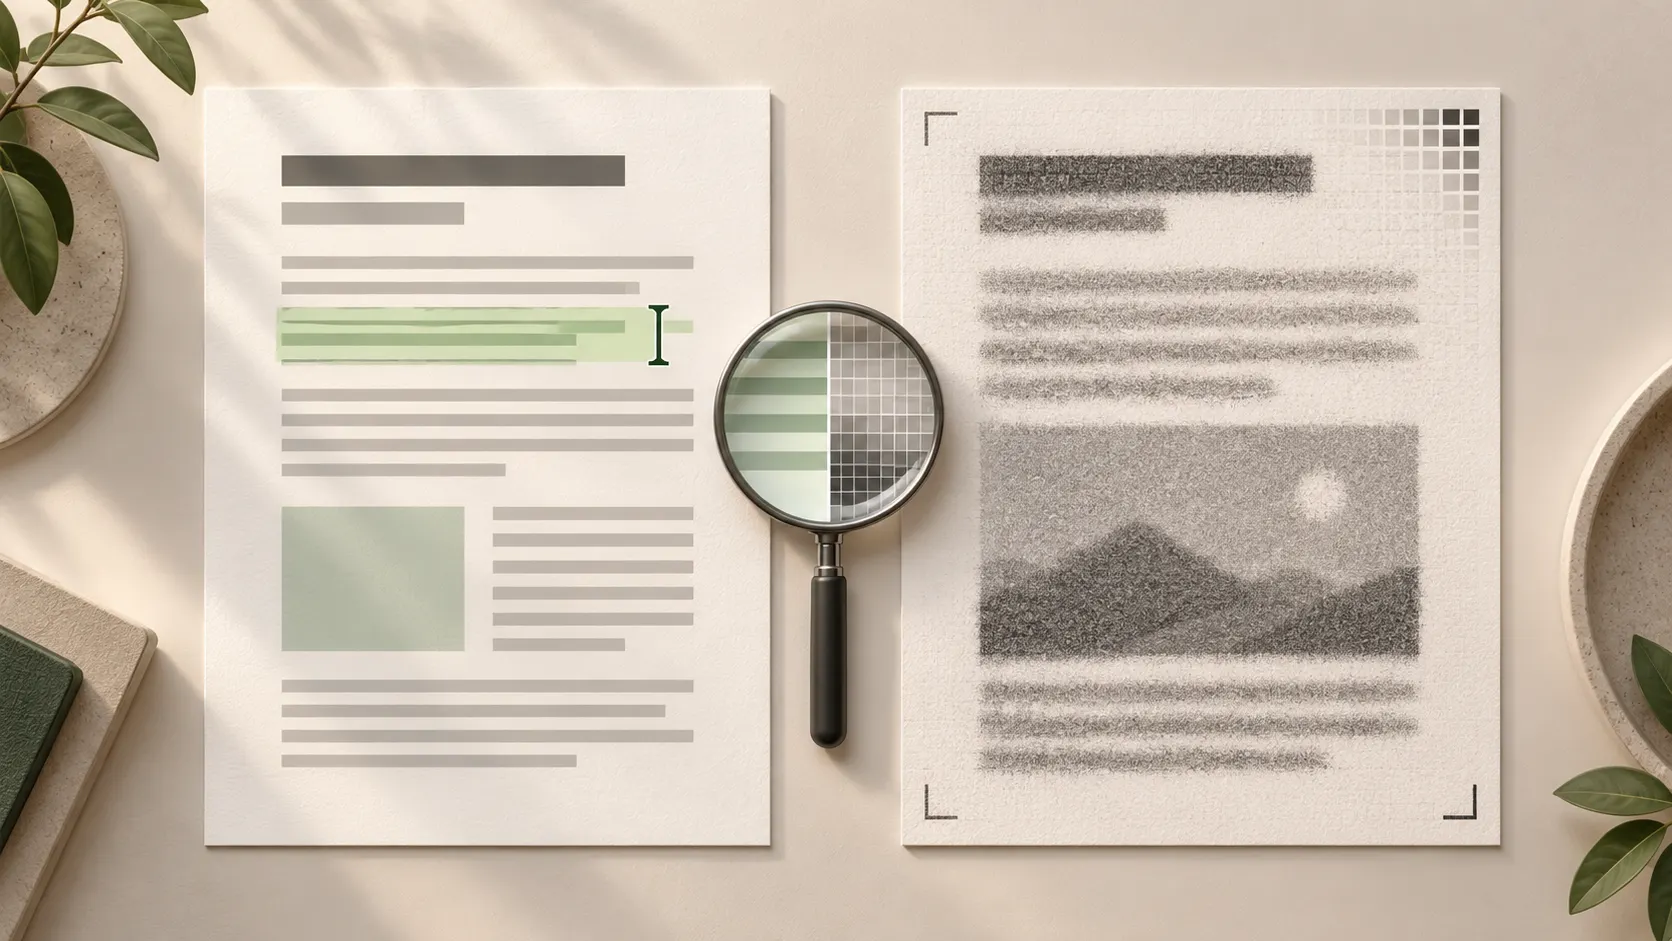
Էկրանի ընթեռնելի պատկերը դեռ չի հաստատում, որ PDF-ում կա արտահանվող տեքստ։ Համեմատեք մեկ կարճ հատվածի տեսքը և արտահանված տեքստը։ Պատկերային էջին կարող է պետք գալ OCR կամ պատկերների ընթերցում աջակցող գործիք, իսկ արդյունքի անունները, թվերն ու տողերի կապերը պետք է համեմատել բնագրի հետ։ Մեր փորձը չափում է տեքստի արտահանումը, ոչ ԱԲ-ի ճշտությունը։
Նույն էջը կարող է ունենալ տարբեր ներքին կառուցվածք
Տեքստային PDF-ում տառերը պահպանված են որպես տեքստային տարրեր։ Միայն պատկեր պարունակող տարբերակում էջը մեկ նկար է. տառերը տեսանելի են մարդուն, բայց սովորական տեքստային արտահանիչը դրանցից ինքնաբերաբար բառեր չի ստանում։ Իրական ֆայլը կարող է նաև խառը լինել կամ ունենալ OCR-ով ավելացված տեքստային շերտ։
pypdf-ի պաշտոնական ուղեցույցը նշում է, որ միայն պատկեր պարունակող էջից արտահանված տեքստը կարող է դատարկ կամ նվազագույն լինել։ Հետևաբար միայն .pdf վերջավորությունը չի ասում, թե ինչ տվյալ է հասանելի ներսում։ Մեծացնելով նկարը՝ դուք այն ավելի տեսանելի եք դարձնում, բայց միայն դրանով տեքստային շերտ չեք ավելացնում։
Ինչ նյութով ենք համեմատել
2026 թվականի նոյեմբերի 1-ին կազմեցինք մեկ էջանոց, ամբողջությամբ պայմանական պատվերի քարտ։ Սա իրական հաճախորդի փաստաթուղթ չէ, գները շուկայի առաջարկ չեն, իսկ նշված օրը առաքման խոստում չէ։ Քարտի վեց դաշտերը հետևյալն են։
Առաջին PDF-ը պատրաստեցինք տեքստային տարրերով։ Ապա դրա էջը վերածեցինք պատկերի և այդ նույն պատկերը տեղադրեցինք երկրորդ PDF-ում՝ առանց OCR կամ նոր տեքստ ավելացնելու։ Սա սկանավորված էջի կառուցվածքը նմանակող մաքուր պատկեր է, ոչ ֆիզիկական սկաների, աղոտ լուսանկարի կամ ձեռագրի փորձ։
- Ապրանք՝ կապույտ տետր։
- Քանակ՝ 12 հատ։
- Միավորի գին՝ 1 250 դրամ։
- Առաքում՝ 1 500 դրամ։
- Ընդամենը՝ 16 500 դրամ։
- Հանձնման պայմանական օր՝ 2026-11-05։
Իրական դիտարկումը՝ նույն տեսքը, տարբեր արտահանում
Երկու PDF-ներն էլ մեկ էջ ունեն։ 150 dpi-ով ստացված էջապատկերները համընկան պիքսել առ պիքսել. երկուսում էլ հայերեն տեքստը և թվերը ընթեռնելի էին, առանց կտրված տողերի։ Այնուհետև նույն ֆայլերից տեքստ արտահանեցինք pypdf 6.10.0 և pdfplumber գործիքներով։
Տեքստային PDF-ից երկու գործիքներն էլ վերադարձրին բոլոր 8 սկզբնական տողերը՝ վերնագիրը, պայմանական լինելու նշումը և վեց դաշտերը։ Երկուսն էլ պահպանեցին թվերն ու ամսաթիվը։ Պատկերային PDF-ից երկուսն էլ վերադարձրին 0 ոչ բացատային նիշ։ Այդ տարբերակում ստուգմամբ կար մեկ պատկերի օբյեկտ։
Այս արդյունքը վերաբերում է մեր երկու պատրաստված ֆայլերին և օգտագործված արտահանիչներին։ ChatGPT-ի վերբեռնում, API հարցում, OCR ճանաչում կամ PDF դիտարկիչում ձեռքով տեքստի ընտրության փորձ չենք կատարել։ Ուստի չենք ասում, որ ԱԲ-ն այդ էջը չէր կարդա կամ որ բոլոր սկանավորված PDF-ներն անընթեռնելի են։
OCR-ը և պատկեր կարդալը նույնը չեն, ինչ տեքստ հանելը
OCR-ը պատկերում գտնվող տառերից տեքստ ստանալու քայլ է։ Adobe-ի պաշտոնական ուղեցույցը բացատրում է, թե ինչպես է սկանավորված PDF-ին ավելացվում որոնելի տեքստ, և խորհուրդ է տալիս ստուգել ճանաչման արդյունքը։ Այդ քայլը մեր փորձի մաս չէր, հետևաբար OCR-ի լեզվական որակի կամ սխալների տոկոս չենք ներկայացնում։
Պատկերային PDF-ի դատարկ արտահանումը նաև չի ապացուցում պատկերներ մշակող ԱԲ-ի անկարողությունը։ OpenAI-ի ընթացիկ API փաստաթուղթը նկարագրում է, որ տեսողական հնարավորություններով մոդելների PDF մուտքում օգտագործվում են և՛ արտահանված տեքստը, և՛ էջերի պատկերները։ Սա API մեխանիզմի նկարագրություն է, ոչ մեր փորձի արդյունքը կամ ձեր ChatGPT հաշվի բոլոր հնարավորությունների հաստատումը։
Որոշման քարտ՝ նախքան ամբողջ նյութը մշակելը
Ընտրեք մեկ փոքր, ոչ գաղտնի հատված՝ մեկ վերնագիր, անուն, թիվ և ամսաթիվ։ Եթե հնարավոր է, պատճենեք կամ արտահանեք այդ հատվածը և համեմատեք էջապատկերի հետ։ Տեքստ ընտրելու հաջող փորձը միայն նախնական նշան է. ստուգեք նաև արդյունքի բովանդակությունը։
Մի շտապեք խնդրել ամբողջ փաստաթղթի գեղեցիկ ամփոփում։ Նախ պարզեք՝ մուտքն ընթերցվե՞լ է։ Եթե միայն մի քանի էջն են խնդիր առաջացնում, առանձնացրեք դրանց համար ստուգվող հատվածը՝ չկորցնելով սկզբնական էջի համարը։
- Տեքստը կա և համապատասխանում է բնագրին՝ շարունակել փոքր հատվածով, ստուգել անուններն ու թվերը։
- Տեքստ չկա՝ ճշտել՝ գործիքն աջակցո՞ւմ է OCR կամ պատկերների ընթերցում. հնարավորության դեպքում վերցնել սկզբնական տեքստային ֆայլը։
- Տեքստ կա, բայց նիշերը սխալ են՝ ստուգել ճանաչումը, տառատեսակը կամ ֆայլի ավելի մաքուր տարբերակը։
- Թվերը ճիշտ են, բայց տողերը խառնվել են՝ վերականգնել դաշտ-արժեք կապերը և համեմատել բնագրի հետ։
- Բովանդակությունը բավարար չի հաստատվել՝ նշել բաց հարցը, ոչ լրացնել բացը ենթադրությամբ։
Պահեք բնագիրն ու ստուգման սահմանը
Սկսեք ձեր կազմած պայմանական օրինակով։ Իրական փաստաթուղթ օգտագործելուց առաջ ճշտեք՝ իրավունք ունե՞ք այն փոխանցելու տվյալ ծառայությանը, և հեռացրեք առաջադրանքին ոչ անհրաժեշտ նույնականացնող կամ գաղտնի տեղեկությունը։ Միայն անունը ծածկելը կարող է անբավարար լինել, եթե էջի այլ մանրամասները նույնականացնում են մարդուն կամ կազմակերպությանը։
Պահեք ֆայլի տարբերակը, ստուգված էջը, գործիքի անունը, ստացված տեքստը և չհաստատված դաշտերը։ Մեր գրառման եզրակացությունը սահմանափակ է՝ նույն տեսք ունեցող PDF-ները կարող են տարբեր տեքստային տվյալ տալ արտահանիչին։ ԱԲ պատասխանի հղումների ստուգումն առանձին քայլ է, իսկ հայերեն նյութի ընդհանուր օգտագործումը՝ առանձին հմտություն։
Ինչ հիշել
- PDF-ի տեսքը և արտահանվող տեքստը տարբեր ստուգումներ են։
- Մեր տեքստային ֆայլից երկու արտահանիչն էլ ստացավ 8 տող, պատկերայինից՝ 0 ոչ բացատային նիշ։
- Այս փորձը ChatGPT-ի, OCR-ի կամ բոլոր PDF-ների ճշտության չափում չէ։
- Ամփոփումից առաջ բնագրով ստուգեք անունները, թվերն ու դաշտերի կապերը։
Հաճախ տրվող հարցեր
Սկանավորված PDF-ը ԱԲ-ն միշտ սխա՞լ է կարդում։
Ոչ։ Արդյունքը կախված է ֆայլից և գործիքի մեխանիզմից։ Մեր փորձը ցույց է տալիս միայն, որ տեքստային արտահանումը և պատկերային էջի ընթերցումը տարբեր գործընթացներ են։
Եթե տեքստը պատճենվում է, այլևս ստուգում պետք չէ՞։
Պետք է։ Պատճենված տեքստը կարող է ունենալ սխալ նիշեր, թվեր կամ խառնված հերթականություն։ Փոքր հատվածը համեմատեք էջապատկերի հետ։
Ձեր օրինակում ChatGPT-ն չի՞ ճանաչել հայերենը։
Այդպիսի փորձ չի կատարվել։ Փաստագրվել են pypdf և pdfplumber արտահանման արդյունքները՝ նույն պայմանական հայերեն քարտի երկու PDF տարբերակներից։
Ո՞ր ֆայլն ընտրել, եթե ունեմ նաև սկզբնական փաստաթուղթը։
Սկսեք առաջադրանքի համար համապատասխան, ստուգելի տարբերակից։ Հասանելի սկզբնական տեքստային նյութը կարող է օգնել, բայց աղյուսակների ու դասավորության պահպանությունը կրկին ստուգեք։
Աղբյուրներ
Ստուգվել է: